


Service Level Agreement — Support und Wartung
Zielwerte und Prozesse für Störungen, Fehler und Sicherheitslücken. Dieses SLA gilt für individuelle Software auf der Infrastruktur des Auftraggebers; verbindliche Bedingungen werden im SOW festgelegt. Jeder Abschnitt bietet kurze Kernaussagen und Übersichtstabellen, damit Einkauf, CTO und Sicherheitsverantwortliche ihn schnell bewerten können.
 Ticket: einziger Erfassungskanal
 CET/CEST · 24×7 je nach Plan
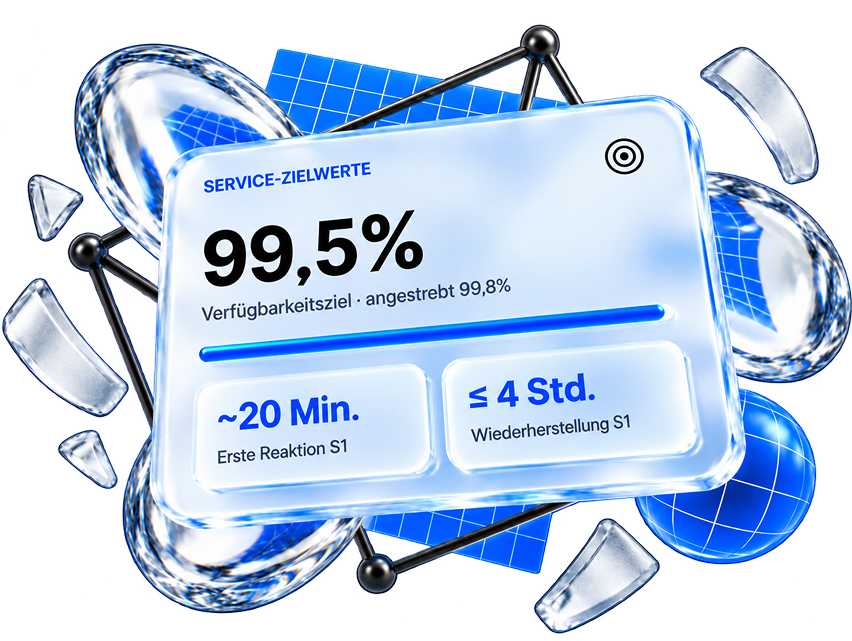
 S1 · Erstreaktion ca. 20 Min.
 S1 · Wiederherstellung bis zu 4 Std.
 Benachrichtigung bei Sicherheitsvorfällen bis zu 48 Std.
 EN · RU · DE
Kernfakten
Dieses SLA beschreibt Zielwerte für Störungen, Fehler und Sicherheitslücken. Standardabdeckung sind Geschäftszeiten nach CET/CEST; 24×7-Bereitschaft (On-Call) je nach Supportplan. Bei kritischen Störungen hat die Wiederherstellung des Dienstes Vorrang vor einer tiefgehenden Ursachenanalyse (RCA).
Erstreaktion bei S1 während der Geschäftszeiten
Wiederherstellung bei S1 (in unserem Kontrollbereich)
Verfügbarkeitsziel (Zielwert 99,8 %)
Pläne: Basic · Extended · Enterprise
Kanal
Ticket: einziger Kanal für die SLA-Erfassung
Anfragen aus Chats können in Tickets überführt werden, um Erfassung und Berichterstattung sicherzustellen.
 Abdeckung
CET/CEST als Standard
Erweiterte Zeiten und 24×7-Bereitschaft je nach Plan. Ein struktureller Vorteil für US-Auftraggeber.
 Ansatz
Wiederherstellung zuerst
Bei S1/S2 hat die Wiederherstellung eines minimal funktionsfähigen Betriebs Vorrang vor der vollständigen Ursachenbehebung.
 Onboarding
Voraussetzung für realistische Zielwerte
Ohne Onboarding werden keine genauen SLA-Zielwerte festgelegt, insbesondere bei übernommenen Systemen.
 Sprachen
EN · RU · DE
EN/RU vollständig unterstützt. DE verfügbar. Weitere Sprachen nach Vereinbarung. KI-gestützte Übersetzung optional.
 Vertrag
Bedingungen im SOW
Servicegutschriften, RPO/RTO, Eskalationsmatrix, Benachrichtigung bei Sicherheitsvorfällen und QBR werden im Vertragsanhang festgelegt.
Geltungsbereich des SLA: enthaltene Leistungen, Ausschlüsse, Verantwortungsgrenzen
Dieses SLA deckt individuelle Software auf der Infrastruktur des Auftraggebers ab. Es gilt ein Modell geteilter Verantwortung: Code und Deployment verantworten wir; Infrastruktur und Drittanbieterdienste verantwortet der Auftraggeber. Liegt die Ursache außerhalb unserer Kontrolle, übernehmen wir Diagnose und Koordination.
 Enthaltene Leistungen

Produktionsstörungen, die Verfügbarkeit oder geschäftskritische Abläufe beeinträchtigen
Fehlerbehebung in kritischen Abläufen: Bestellvorgang, Zahlungen, Kontozugang
Sicherheitslücken und Sicherheitsvorfälle (hohe Priorität)
Koordination mit Drittanbietern (je nach Plan)
 Ausschlüsse

Ausfälle von Rechenzentren oder Infrastruktur, die nicht von unserem Team betrieben werden
Ausfälle von Drittanbieterdiensten (Zahlungsanbieter, APIs, E-Mail-Marketing-Plattformen)
Teilsysteme, die nicht von unserem Team entwickelt wurden (nur Diagnose)
Fälle, in denen erforderliche Zugänge nicht bereitgestellt wurden
Modell geteilter Verantwortung
 Unsere Verantwortung
 Verantwortung des Auftraggebers
 Anwendung
 Infrastruktur
 Drittanbieterdienste
 Gemeinsam

Liegt die Ursache außerhalb unserer Kontrolle, identifizieren wir den abhängigkeitsbedingten Fehler, stellen technischen Kontext und Protokolle (Logs) bereit, unterstützen als technischer Vermittler bei der Kommunikation mit dem Anbietersupport (sofern im Plan vorgesehen), dokumentieren Erkenntnisse im Ticket und schlagen Maßnahmen zur Schadensbegrenzung oder Umgehungslösungen auf unserer Seite vor.
Definitionen: Ticket, Störung, Fehler, Änderungsanfrage, Erstreaktion
Ein Ticket ist die Basiseinheit für die SLA-Erfassung. Eine Störung (Incident) ist ein Produktionsausfall. Ein Fehler (Bug) ist ein fehlerhaftes Verhalten einer bestehenden Funktion. Eine Änderungsanfrage (Change Request) ist eine geplante Weiterentwicklung, keine Störung. Dringende Änderungen aufgrund externer Fristen können außerhalb der regulären Warteschlange priorisiert werden.
Erstreaktion · Sofortmaßnahmen · Vollständige Behebung
Bestätigung und Arbeitsbeginn
Das Ticket ist bestätigt, das Team bestätigt den Eingang und beginnt mit der Bearbeitung. Bei Bedarf wird eskaliert.
Minimaler funktionsfähiger Betrieb
Rückführung des Dienstes in einen funktionsfähigen Zustand, auch im eingeschränkten Modus. Standardansatz bei kritischen Störungen.

Beseitigung der Ursache
Umfassende Korrektur, die die Ursache beseitigt. In komplexen Fällen nach der Dienstwiederherstellung.
Supportzeiten, Zeitzonen, Feiertage, Sprachen
Standardabdeckung sind Geschäftszeiten nach CET/CEST. Erweiterte Abdeckung umfasst Reaktion außerhalb der Geschäftszeiten, Bereitschaftsdienst (On-Call) mit Zeitzonenüberlappung zum Auftraggeber sowie Deployment-Planung in geeigneten Fenstern. Feiertagskalender werden nach Leistungsort abgestimmt und im SOW dokumentiert.


Unterstützte Sprachen
 Englisch — vollständig
Russisch — vollständig
 Deutsch — verfügbar
Weitere — nach Vereinbarung
KI-gestützte Übersetzung — optional
Eingangskanäle und erforderliche Angaben
Offizieller Kanal für die SLA-Erfassung ist das Ticketsystem. Eine Anfrage sollte Beschreibung, Zeitfenster, Ort des Auftretens (Seite / Route / API), geschäftliche Auswirkung und nach Möglichkeit Screenshots, Logs und Trace-IDs enthalten. Ohne die erforderlichen Zugänge kann der Support auf Änderungen auf Repository-Ebene beschränkt sein.
 Mindestangaben in einer Anfrage
Was ist passiert — kurze Beschreibung
Wann — Zeitfenster
Wo — Seite / Route / API / Umgebung
Geschäftliche Auswirkung — was blockiert ist, wer betroffen ist
Kritikalität — erste Einschätzung des Auftraggebers (falls möglich)
Nachweise — Screenshots, Logs, Trace-IDs, Fehlermeldungen
 Zugangsvoraussetzungen und operative Einschränkungen

Ohne Produktionszugang ist der Support auf Änderungen auf Repository-Ebene beschränkt

Infrastrukturausfälle (CI/CD, Laufzeitumgebung) können ohne Zugang zur betreffenden Ebene nicht behoben werden

Zugangsvoraussetzungen werden beim Onboarding festgelegt

Chats können genutzt werden, Anfragen müssen jedoch für die SLA-Erfassung in Tickets überführt werden
Kritikalitäts- und Prioritätsmodell: S1–S4 und Zuordnung zu P0–P4
4-stufiges Kritikalitätsmodell S1–S4, kompatibel mit Enterprise-Prioritätsstufen P0–P4. S1/P0: vollständiger oder teilweiser Dienstausfall. S2/P1: erhebliche Beeinträchtigung mit verfügbaren Umgehungslösungen. S3–S4: begrenzte Auswirkung, geplante Warteschlange.
Zielwerte des Service: Reaktion, Wiederherstellung, Kommunikation
Endgültige Zielwerte richten sich nach dem Supportplan und werden im SOW dokumentiert. Typische Erstreaktionszeit bei S1 während der Geschäftszeiten: ca. 20 Minuten. Zielwert der Dienstwiederherstellung bei S1: bis zu 4 Stunden (wenn die Ursache in unserem Kontrollbereich liegt). Statusaktualisierungen: von alle 30 Minuten (Enterprise) bis alle 4 Stunden (Basic).
Wiederherstellung (Sofortmaßnahmen) und vollständige Behebung
Frequenz der Statusaktualisierungen nach Plan

Kommunikationsmeilensteine
Bestätigt
bestätigt, Arbeit begonnen

Diagnose
Fehlerbereich lokalisiert
Wiederhergestellt
Sofortmaßnahmen umgesetzt
Behoben
Korrektur ausgerollt

Empfehlungen
RCA und Folgemaßnahmen

Blockiert
fehlende Zugänge oder Zulieferungen

Wenn der Fortschritt durch fehlende Zugänge oder fehlende Zulieferungen des Auftraggebers blockiert ist, kann die Arbeit ausgesetzt werden. Die verstrichene Zeit beinhaltet die Wartezeit, sofern nicht anders vereinbart, da die Störung ohne die erforderlichen Voraussetzungen nicht behoben werden kann.
Eskalationsmodell: Rollen, Stufen, Einbindung der Führungsebene
3-stufige Eskalation: Bereitschaftsingenieur → Technische Leitung / Projektleitung → CTO / Architekt. Die Eskalation wird sofort ausgelöst, wenn Fachkontext oder Zugang fehlt. Für Enterprise werden zeitbasierte Schwellenwerte im SOW dokumentiert.
Eskalationsstufen
Bereitschaftsingenieur / zugewiesener Ingenieur — Erstreagierende/r
Projektleitung / Technische Leitung — Fachverantwortliche/r
CTO / Architekt — komplexe oder kritische Fälle
CEO — finanzielle Verluste, Reputationsrisiko
Zeitbasierte Schwellenwerte (S1, Enterprise)
Wann eine Eskalation erfolgt
Sofort
Fachkontext fehlt
Dem/der Erstreagierenden fehlt der Fachkontext oder Zugang (z. B. Zahlungsmodul, Infrastrukturebene).
Während der Untersuchung
Die Untersuchung reicht tiefer
Die Störung führt in ein Teilsystem, für das die erforderlichen Zugänge oder Kompetenzen fehlen.
Führungsebene
Direkte Verluste / Sicherheit
Finanzielle Verluste, ein Reputationsvorfall oder ein kritischer Sicherheitsvorfall, der eine schnelle Eindämmung erfordert.
Störungsmanagement · RCA · Überwachung
Für S1/S2 gilt „Wiederherstellung zuerst“: Der minimal funktionsfähige Betrieb wird vor einer tiefgehenden Ursachenanalyse wiederhergestellt. Maßnahmenkatalog: Deaktivierung einer Funktion, Sperrung einer Route, Hotfix-Bereitstellung. Die RCA folgt nach der Stabilisierung in kompakter Form. Überwachung nach Plan: synthetische Verfügbarkeitsprüfungen, Überwachung des Zertifikatsablaufs, inhaltliche Prüfungen, Infrastrukturmetriken.
Maßnahmenkatalog zur Schadensbegrenzung
Funktion deaktivieren oder einschränken
Vorübergehende Deaktivierung einer fehlerhaften Komponente, um Kaskadenausfälle zu verhindern.
Route oder Endpunkt sperren
Isolierung einer überlasteten Route, um die Ausbreitung der Last zu stoppen.
Notfallmaßnahmen zur Lastreduzierung
Reduzierung der Infrastrukturlast, während die Anwendung untersucht wird.
Gezielter Hotfix
Gezielte Korrektur eines konkreten Problems bei eindeutiger Ursache.
Notfall-Rollback
Rücknahme einer kürzlichen Änderung bei Verdacht auf Regression.
Eingeschränkter Modus
Betrieb mit begrenzter Funktionalität, während die vollständige Wiederherstellung fortgesetzt wird.
Ursachenanalyse (RCA) / Nachbetrachtung (Postmortem)
Überwachung nach Plan
Sicherheitslücken und Sicherheitsvorfälle
Sicherheitslücken und -vorfälle werden mit hoher Priorität behandelt: Eindämmung, Reduzierung des Gefährdungsfensters, Einbindung leitender technischer Rollen. Für Enterprise beträgt die Benachrichtigungsfrist bei bestätigtem Vorfall bis zu 48 Stunden (bis zu 24 Stunden durch gesonderte Vereinbarung). Auftraggeber werden bei hochriskanten Schwachstellen auch vor Bestätigung einer Ausnutzung benachrichtigt.
 Prinzip 1
Eindämmung zuerst
Schnelle Schadensbegrenzung zur Schließung des Gefährdungsfensters vor einer tiefgehenden Analyse.
Prinzip 2
Verifizierung
Verifizierung, dass die Schwachstelle gesperrt oder kontrolliert ist.
Prinzip 3
Einbindung leitender Rollen
Einbindung leitender technischer Rollen bei Bedarf.
Benachrichtigung des Auftraggebers
Praktiken der sicheren Softwareentwicklung

Zertifizierung. Eine formale Zertifizierung (SOC 2 / ISO 27001) liegt derzeit nicht vor; eine Zertifizierung ist im Zeitraum von 12–15 Monaten geplant. Ein Sicherheitsfragebogen mit Beschreibung der angewandten Kontrollmaßnahmen ist auf Anfrage verfügbar.
Daten, Zugänge, Codequalität und Tests
Die Daten des Auftraggebers werden standardmäßig auf dessen Infrastruktur verarbeitet. Testumgebungen (Staging) bei Webdelo werden nur für unkritische Projekte oder bei fehlendem Zugang zu Produktivdaten genutzt (mit Testdaten). Bei Vertragsbeendigung werden Zugänge kontrolliert entzogen. Zielwert der automatisierten Testabdeckung: nicht weniger als 90 %, für kritische Geschäftspfade 100 %.
Modell der Datenverarbeitung
Codequalität und Testabdeckung

Unit- und Integrationstests; Testarten und -tiefe werden projektspezifisch im SOW vereinbart.

Zahlungen, Kundendatenverarbeitung, Kerngeschäftslogik und Authentifizierung sind vollständig abgedeckt.

Statische Analyse in der CI/CD-Pipeline; SAST/DAST laut SOW.

Wenn der Auftraggeber beschließt, die Testabdeckung zur Budgetoptimierung zu reduzieren, muss diese Entscheidung schriftlich bestätigt werden (Ticket, E-Mail oder SOW-Nachtrag). Der Auftraggeber erkennt die damit verbundenen Risiken an: erhöhte Wahrscheinlichkeit von Regressionen, längere Diagnosezeiten und höhere Kosten zukünftiger Änderungen; die Entscheidung und ihre potenziellen Auswirkungen werden im Projekt-Risikoregister dokumentiert.
Änderungsmanagement: Freigabeprozess, Wartungsfenster, Rollback, Notfalländerungen
Änderungen folgen einem strukturierten Freigabeprozess über Tickets. Für Enterprise ist eine Integration in den Änderungsmanagementprozess des Auftraggebers möglich (Sprints, Freigabekommitees). Ein Rollback-Plan ist für kritische Änderungen obligatorisch. Notfalländerungen bei Totalausfall können ohne vorherige Freigabe angewendet werden; der Auftraggeber wird umgehend danach benachrichtigt.

Was als Änderung gilt
Code-Deployments (neue Funktionen, Fehlerbehebungen, Refactoring)
Aktualisierungen von Abhängigkeiten und Frameworks
Konfigurationsänderungen (Umgebungsvariablen, Routing, Zugriffsregeln)
Infrastrukturänderungen in unserem Verwaltungsbereich
Wartungsfenster
Kleinere Projekte: Deployment während der Geschäftszeiten ohne formales Wartungsfenster
Enterprise und kritische Systeme: Wartungsfenster werden im Voraus vereinbart und im SOW dokumentiert
Planung angepasst an die Geschäftszeiten des Auftraggebers (Nacht- oder Frühstundenfenster)
Zur Freigabe berechtigte Ansprechpartner werden im SOW geführt
Übersicht der Supportpläne: Basic · Extended · Enterprise
Drei Pläne mit steigender Abdeckung und steigenden Verpflichtungen. Preise werden nicht veröffentlicht: Die Kosten hängen von Technologie-Stack, Anzahl der Integrationen, erforderlicher Seniorität der Ingenieure, Anforderungen an Kommunikation und Berichterstattung sowie Einschränkungen bei der Datenverarbeitung ab. Alle Bedingungen werden im SOW festgelegt.
 Enterprise
99,5 % Verfügbarkeit: wo sie gilt
— für Systeme, bei denen wir vollen Zugang zur Anwendungsebene und zum Deployment-Prozess haben und die Infrastruktur stabil und angemessen kontrolliert ist. Keine bedingungslose Garantie: Die Verfügbarkeit hängt vom Hosting-Anbieter, von Drittanbieterdiensten, von der rechtzeitigen Bereitstellung von Zugängen durch den Auftraggeber und von der architektonischen Reife ab. Projektspezifische Zielwerte werden nach der Systembewertung im SOW dokumentiert.
Warum keine öffentlichen Preise

Technologische Komplexität
Go-Microservices, Laravel, Symfony, Altsysteme, gemischte Umgebungen.
Drittanbieter
Zahlungssysteme, externe APIs, Datenanbieter: Jede Integration erhöht die Komplexität.
Senior/Lead vs. Standard
Die Teamzusammensetzung richtet sich nach Kritikalität und Systemkomplexität.

Frequenz und Kanäle
Aktualisierungsfrequenz, 24×7-Verfügbarkeit und Anzahl der Kanäle wirken sich direkt auf die Kosten aus.

Werkzeuge und Integrationen
Jira, ServiceNow, Dashboard-Zugang, individuelle Berichterstattung.
Tiefe der Praktiken
Sicherheitsaudits, Penetrationstests, Einschränkungen bei KI-Werkzeugen und Datenverarbeitung.
Enterprise-Bedingungen und vertragliche Anhänge (SOW)
Der Enterprise-Plan umfasst vertragliche Verpflichtungen in 6 Bereichen: Servicegutschriften, Eskalationsmatrix, Frequenz der Statusaktualisierungen, RPO/RTO, Benachrichtigung bei Sicherheitsvorfällen und vierteljährliche Serviceüberprüfungen (QBR). Alle Bedingungen werden im SOW dokumentiert und können mit Neuberechnung der Servicegebühr angepasst werden.

Servicegutschriften
Keine Arbeitsaufnahme bei einem S1-Vorfall innerhalb der vereinbarten Erstreaktionszeit
ab 2 % der monatlichen Supportgebühr pro Vorfall
nicht mehr als 30 % der monatlichen Supportgebühr pro Abrechnungszeitraum
Servicegutschrift (Rabatt) auf den nächsten Abrechnungszeitraum
Nur Erstreaktion/Arbeitsbeginn, nicht die vollständige Behebungsdauer
Prozentsätze, Obergrenzen und Metriken sind anpassbar; die Servicegebühr wird neu berechnet

Notfallwiederherstellung: RPO / RTO und Datensicherungen
Werden pro System nach einem Audit festgelegt
Datenbanken, Dateispeicher, Caches, Warteschlangen usw.
vollständig / inkrementell / differenziell
Aufbewahrungsfrist im SOW festgelegt
MySQL + Redis + MongoDB und andere Kombinationen
Empfohlen: nicht seltener als einmal pro Monat für Produktionssysteme
Testen der Notfallwiederherstellung
 Häufigkeit
Monatlich (empfohlen)
Für kritische Systeme: zweiwöchentlich oder wöchentlich, wenn der Auftraggeber Budget bereitstellt.
 Umfang
Dateisystem + alle Datenbanken
Das Dateisystem und alle Datenbanken (relational, NoSQL, Caches, Warteschlangen).
 Testmarker
Marker in den Daten
Marker-Datensätze werden im Voraus vorbereitet, um die Wiederherstellung älterer und aktueller Daten zu verifizieren.
Serviceüberprüfung · QBR
Ticketbericht, wichtigste Störungen, Stabilitätsrisiken
Maßnahmenplan, Verbesserungen der Überwachung, Empfehlungen zur Stabilisierung/Refaktorisierung
Wie oben, plus vertiefte Trendanalyse
Erweiterte Empfehlungen
Onboarding · Altsysteme · Kontinuität
Onboarding ist obligatorisch für zuverlässige Zielwerte: Einrichtung der Zugänge, Überprüfung von Architektur und Abhängigkeiten, Identifizierung geschäftskritischer Abläufe, Analyse der Störungshistorie, Vereinbarung zur Überwachung. Bei Altsystemen dauert diese Phase länger, und wir können nicht dasselbe Garantieniveau bieten wie bei selbst entwickelten Systemen. Die Kontinuität wird durch Dokumentation, Betriebshandbücher (Runbooks) und die Reduzierung der Abhängigkeit von Schlüsselpersonen sichergestellt.
Onboarding · Zeiträume
Einarbeitung eines neuen Teammitglieds
Grundprinzipien für Legacy-Systeme
Kein Ausschlusskriterium
Legacy-Code ist kein Grund, ein Projekt abzulehnen.
Ehrliche Erwartungen
Wir können nicht dasselbe Garantieniveau bieten wie für selbst entwickelte Systeme.
Onboarding ist entscheidend
Architektur-Discovery, Abhängigkeitskartierung, Risikobewertung.
Schrittweise Verbesserung
Zuerst Stabilisierung, dann gezieltes Refactoring als geplanter Arbeitsbereich.
Budget für die Bestandsaufnahme
Die initiale Bewertung bestimmt realistische SLA-Zielwerte.
Tests + Dokumentation
Der schnellste Weg zu einem höheren Serviceniveau.
Dienstkontinuität und Wissensmanagement
Rechtlicher Hinweis / Haftungsausschluss SLA
Dieses Dokument beschreibt Zielwerte und Prozesse und stellt weder eine Garantie noch ein verbindliches Angebot dar. Alle Informationen werden „wie besehen“ (as is) ohne ausdrückliche oder stillschweigende Gewährleistung bereitgestellt, einschließlich, aber nicht beschränkt auf stillschweigende Gewährleistungen der Marktgängigkeit und der Eignung für einen bestimmten Zweck. Verbindliche Leistungspflichten, Haftung und Servicegutschriften ergeben sich ausschließlich aus dem individuell geschlossenen Vertrag (Master Service Agreement / SOW).
Haftungsausschluss SLA
Dieses Dokument beschreibt Zielwerte und Prozesse und stellt weder eine Garantie noch ein verbindliches Angebot dar. Alle Informationen werden „wie besehen“ (as is) ohne ausdrückliche oder stillschweigende Gewährleistung bereitgestellt, einschließlich, aber nicht beschränkt auf stillschweigende Gewährleistungen der Marktgängigkeit und der Eignung für einen bestimmten Zweck. Verbindliche Leistungspflichten, Haftung und Servicegutschriften ergeben sich ausschließlich aus dem individuell geschlossenen Vertrag (Master Service Agreement / SOW).
